 SEO SpiderSnabb crawler för teknisk SEO-analys
Varför en egen SEO-crawler?
Screaming Frog SEO Spider är förebilden, och jag hade fortsatt använda den om den inte hade en dålig prenumerationsmodell. Inte ens en tidigare version får man behålla när prenumerationen är slut.
SEO Spider
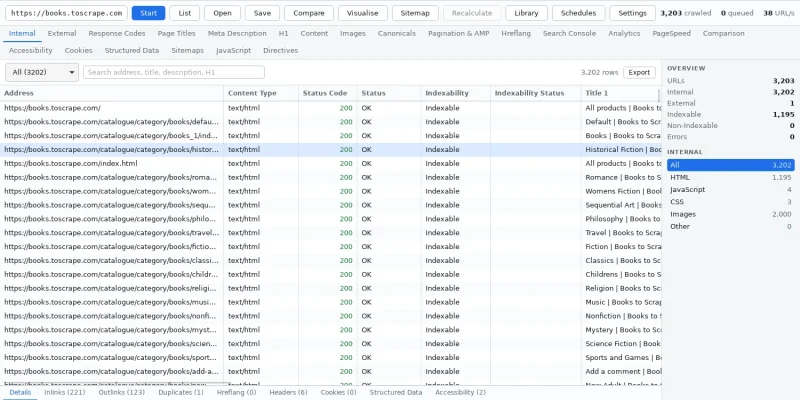
SEO Spider går igenom en sajt sida för sida, som en sökmotor, och visar allt som spelar roll för teknisk SEO: statuskoder, omdirigeringar, sidtitlar, metabeskrivningar, rubriker, canonical, indexerbarhet, bilder, länkar och mycket mer. Resultatet visas i en tabell med flikar och filter, och varje sida har en detaljpanel med inlänkar, utlänkar, dubbletter, huvuden och kakor. Namnen på flikar och filter följer Screaming Frog, så att det går att jämföra verktygen.
Det appen gör:
- tjugo flikar och 129 filter: Response Codes, Page Titles, Canonicals, Hreflang, Structured Data, Sitemaps, Accessibility med flera – till exempel titlar som saknas, är dubbletter eller är för långa
- JavaScript-rendering i en headless Chrome, med en jämförelse mellan den råa och den renderade sidan
- länkgraf och länkstyrka över de interna sidorna, och XML-sitemaps som läses, jämförs med crawlen och kan genereras
- egen extraktion och sökning: hämta ut fält med CSS-selektorer eller reguljära uttryck, eller hitta alla sidor vars källkod innehåller en viss text
- nära dubbletter, tillgänglighet (sjutton statiska regler eller axe-core i den renderade sidan), kakor, hreflang, paginering och AMP
- list-läge för att kontrollera exakt en lista med adresser, till exempel efter en migrering
- crawl-bibliotek, jämförelse mellan två crawls och schemaläggning, och en crawl som kan pausas och fortsätta även efter omstart
- ett CLI som kör samma motor utan fönster
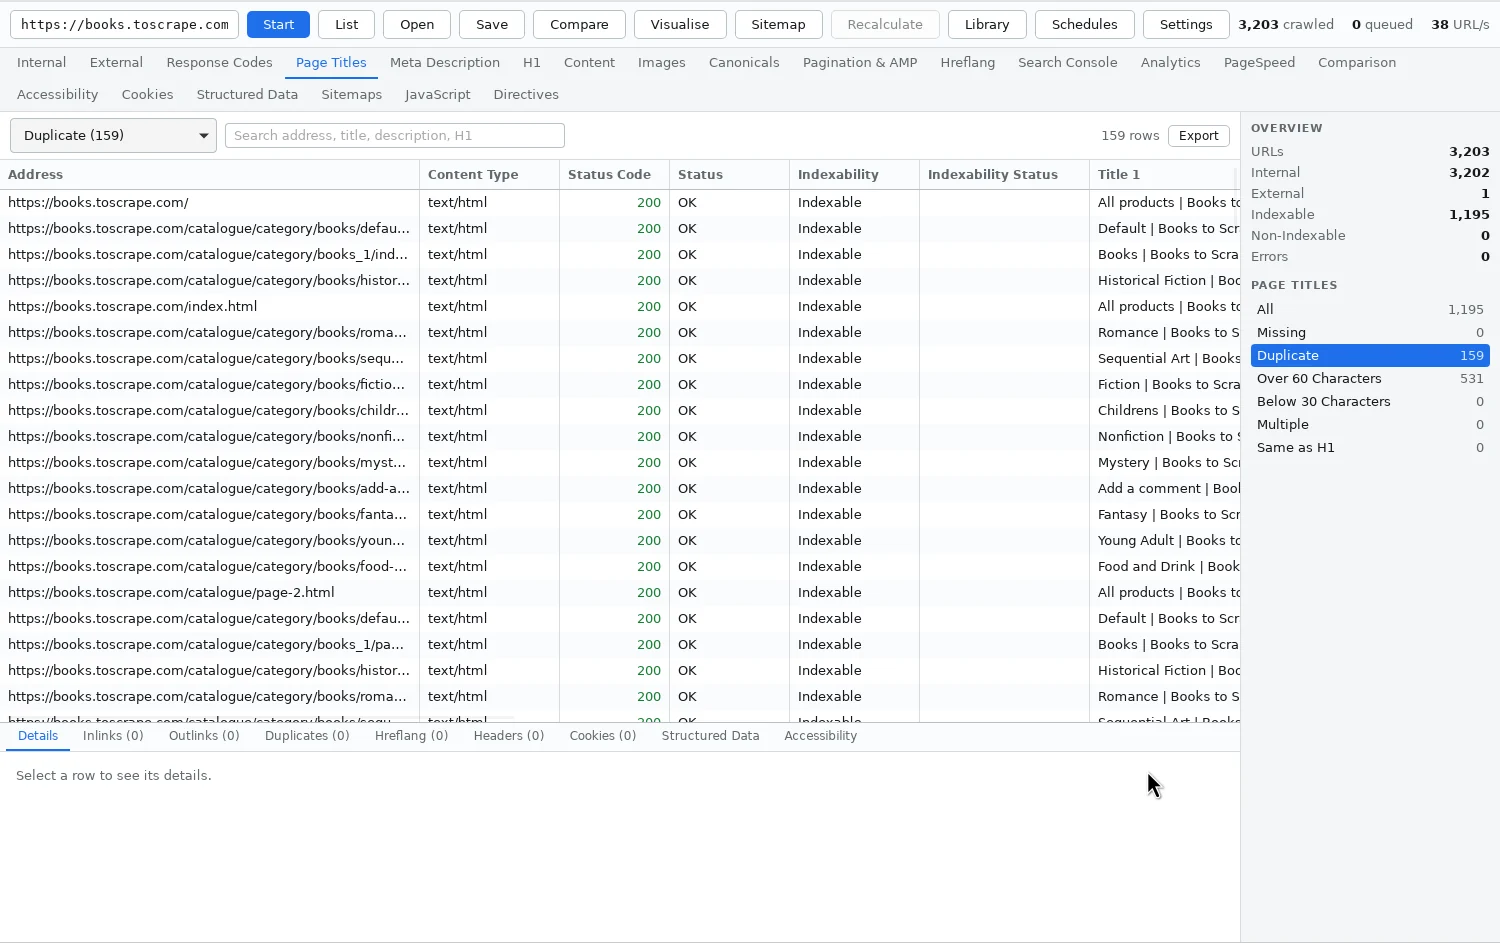
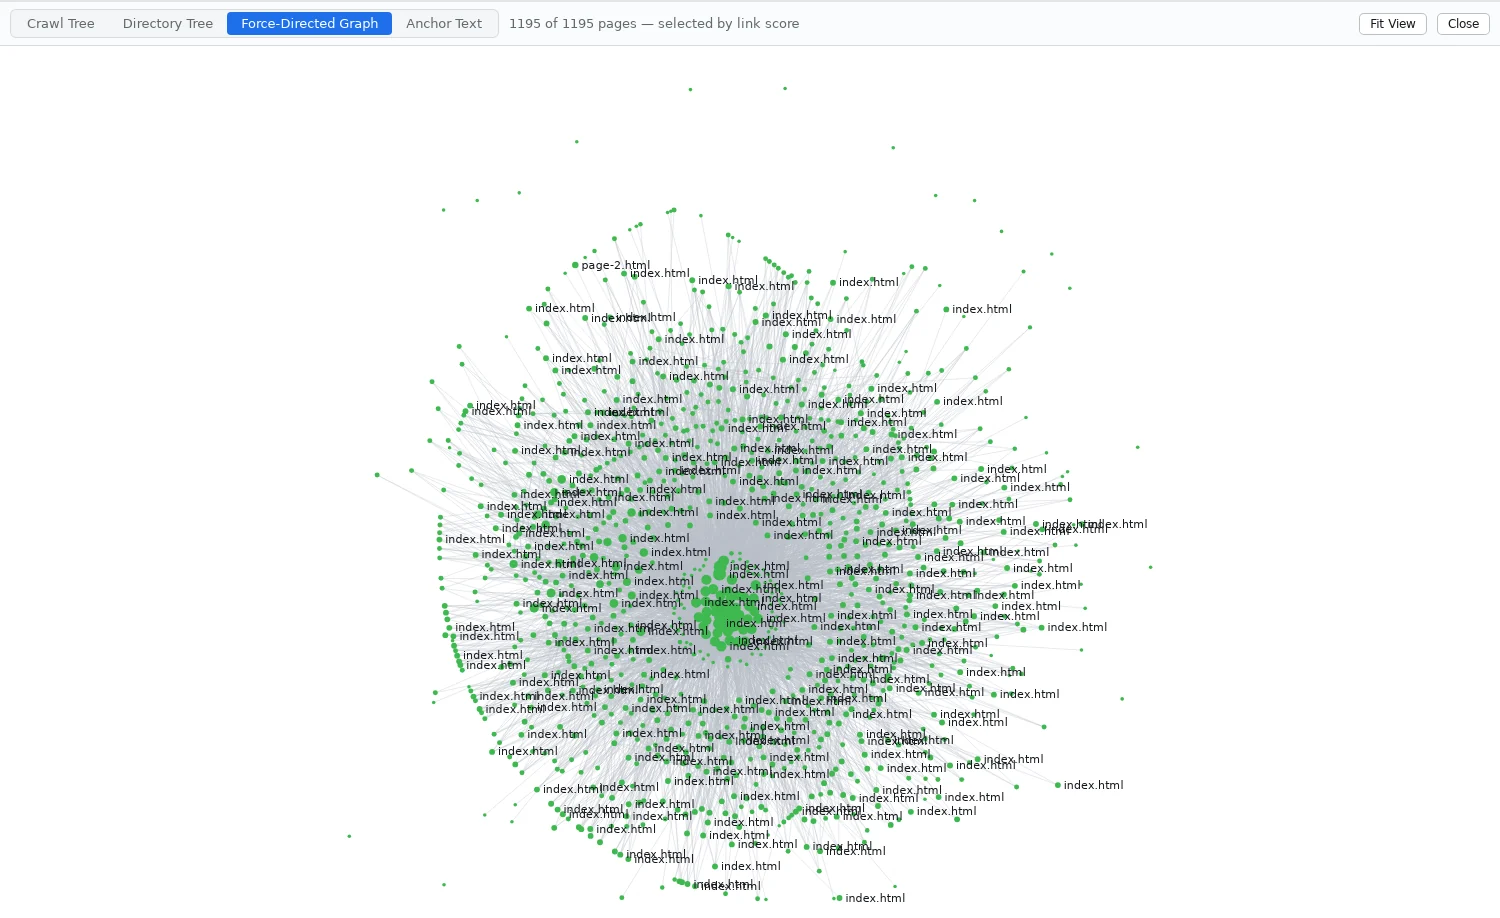
Det finns också visualiseringar: crawl-träd, katalogträd, kraftdiagram och ordmoln över ankartexter.
Kopplingarna till Search Console, Analytics och PageSpeed Insights är byggda men ännu inte provade mot ett riktigt konto.
Programmet är byggt med Claude Code, i Rust med ett gränssnitt i Tauri och React, för Windows och macOS, och ikonen är gjord med Codex. Tre val i bygget står för farten:
- Sidorna läses i ett enda svep med
lol_html, utan att bygga upp ett dokumentträd. Med en tråd klarar det 1 900 verklighetsnära sidor i sekunden, så det är nätverket och servern som sätter taket – aldrig tolkningen. - En enda uppgift äger kön av adresser som ska hämtas. Arbetarna hämtar och tolkar och skickar tillbaka färdiga resultat, utan lås.
- Resultatet frågas kolumnvis med Polars, så att sortering och filtrering av hundratusentals rader går fort.
Arbetet styrdes från en ärendebräda, som i mina andra projekt. Det finns drygt 350 tester i Rust och ett tjugotal för gränssnittet, och appen provas också i ett körande fönster.
På vägen
Att spara en crawl fungerade inte alls på Windows. En sparad crawl syntes ingenstans, och ett nytt försök gav ett fel om en låst fil. Databasen låser sin fil, och på Windows gäller ett sådant lås för alla – även den som bara vill läsa och kopiera. På Linux är låset bara en rekommendation, så felet syntes aldrig där. Nu skrivs kopian genom databasens eget öppna handtag.
Lösenordet hamnade i crawl-filen. Vid crawl bakom inloggning sparades de huvuden som skickades i filen – inklusive det med användarnamn och lösenord, som gick att läsa rakt ut. Koden lovade motsatsen i en kommentar. Nu sparas namnen på de huvuden användaren själv lagt till, men inte värdena.
Externa sitemaps drog in hela internet. Under en crawl av en riktig sajt växte kön plötsligt från runt 1 000 till 230 000 adresser. För varje extern länk lästes den sajtens robots.txt, och dess sitemaps köades – med nya externa länkar, nya robots.txt och nya sitemaps. Nu följs sitemaps bara för den egna sajten, och externa adresser kontrolleras bara: statuskod och huvuden, inget innehåll.
Noindex i svarshuvudet missades. En sida som sätter X-Robots-Tag: noindex i svaret rapporterades som indexerbar. Det är ofta just så PDF:er och andra filer utan HTML-huvud styrs. Nu läses huvudet som metataggen.
Två renderande crawls dödade varandra. Den inbyggda Chrome startades alltid med samma profilkatalog, så en andra crawl med JavaScript – från appen och CLI:t samtidigt – krockade med den första. Nu får varje crawl en egen.
Jämfört med Screaming Frog
Screaming Frog är förebilden, och den kan fortfarande mer. Den kan till exempel logga in via formulär och hämta ut fält med XPath. SEO Spider är snabbare. Tolkningen av sidorna är uppmätt, men en jämförelse sida vid sida med Screaming Frog har jag inte gjort än.
Det SEO Spider ger mig:
- ingen prenumeration – programmet är mitt
- en snabbare crawler
- samma program på Windows och macOS, och ett CLI för skript
- en crawl-fil som kan räknas om utan att sajten crawlas igen
Prova själv
Under Filer ligger IDEA.md: en fullständig beskrivning av programmet och allt jag lärt mig under bygget, skriven som en uppdragsbeskrivning. Ge den i sin helhet till Claude Code så har du underlaget för en egen SEO-crawler – stacken, de beslut som visade sig avgörande, fallgroparna ovan som regler och en färdig prompt att utgå från.